GEO un an après : le référencement IA qui marche vraiment
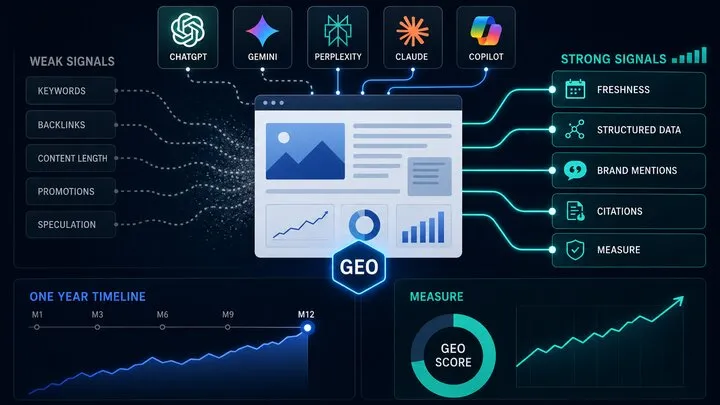
En résumé : Au 5 septembre 2026, le GEO améliore surtout la manière dont une source déjà retenue est citée ; il ne garantit ni découverte, ni classement, ni trafic. Priorisez un contenu answer-first, une entité cohérente, des mentions tierces et des mises à jour utiles. Un fichier llms.txt peut offrir un sommaire à l’agent qui le consulte, sans bénéfice démontré. Mesurez chaque moteur séparément avec un protocole stable.
En un an, le GEO — Generative Engine Optimization, c’est-à-dire le référencement d’un site pour les réponses des assistants IA comme ChatGPT, Perplexity, Gemini ou Claude — est passé d’un acronyme expérimental à une case à cocher dans presque tous les outils SEO. Rien à voir avec la géolocalisation : l’objectif est de faire citer votre contenu, pas de le géolocaliser. Générer un fichier, ajouter quelques données structurées et suivre un score donnent l’impression d’un nouveau canal maîtrisable. La réalité reste plus nuancée. Dans l’échantillon étudié par SE Ranking, les referrals attribués aux assistants IA représentent 0,32 % des sessions en 2026, contre 0,24 % en 2025 et 0,02 % en 2024. Le volume reste faible, mais l’intention de certaines visites peut être forte. Il faut l’évaluer sur vos propres conversions, pas à partir d’une moyenne universelle.
Après douze mois d’outils et de promesses, la bonne question n’est donc plus « faut-il faire du GEO ? », mais que sait-on réellement améliorer ?
Un an après, que prouve vraiment le GEO ?
Les preuves portent surtout sur la présentation d’une source déjà sélectionnée, beaucoup moins sur sa découverte, son classement ou son trafic. Cette distinction empêche de transformer une technique utile en promesse impossible.
Ce qui tient : améliorer la proéminence
Un moteur découvre ou récupère des documents, en sélectionne certains, construit une réponse, puis choisit ses citations. La proéminence (prominence) décrit la visibilité accordée à une source : place, fréquence et association avec une affirmation.
Une revue critique de juillet 2026 analyse 45 études. Le fameux gain de « +40 % » associé aux travaux de Princeton venait d’un environnement expérimental limité à cinq documents. Il mesurait la proéminence, pas des visites, des leads ou des conversions.
Ce qui ne se vérifie pas : la recette universelle
Aucune checklist GEO ne garantit une présence dans les réponses IA. Un test de bout en bout cité dans l’analyse critique de Buffy a même observé qu’une réécriture trop orientée « citation » réduisait d’environ 16 % la présence dans le top 10.
Google AI Overviews illustre aussi la différence avec le SEO classique. En février 2026, ces réponses apparaissaient sur 48 % des requêtes suivies, tandis que seulement 17 % de leurs citations provenaient du top 10 organique, selon BrightEdge. Le classement traditionnel compte encore, mais il ne suffit pas à expliquer la sélection générative.
Pourquoi les assistants IA n’obéissent-ils pas aux mêmes règles ?
Chaque laboratoire combine ses propres robots, index, sources tierces et mécanismes de récupération ; une règle globale serait trompeuse. Une autorisation dans robots.txt n’a pas le même sens pour un robot d’entraînement, un index de recherche ou une récupération déclenchée par un utilisateur.
Observations publiées sur les laboratoires
Le tableau rapproche les observations de l’étude EZY, menée sur 83 sites pendant 12 semaines, et la documentation officielle. C’est une photographie au 5 septembre 2026, pas un comportement contractuel ni une prédiction.
| Lab | robots.txt | llms.txt | JSON-LD | JS rendu | Opt-out |
|---|---|---|---|---|---|
| OpenAI | documenté par robot | observé dans cet échantillon | non documenté | non documenté | documenté par robot |
| Anthropic | documenté par robot | observé dans cet échantillon | documenté via web_fetch |
non documenté | documenté par robot |
| documenté selon l’usage | observé dans cet échantillon | documenté | oui (Web Rendering Service) | documenté | |
| Perplexity | documenté selon le robot | non observé dans cet échantillon | documenté pour les citations | non documenté | documenté selon le robot |
| Meta | documenté selon le robot | observé dans cet échantillon | non documenté | non documenté | documenté par robot |
Google peut exécuter JavaScript et effectuer le rendu des pages avec son Web Rendering Service. Pour les autres laboratoires du tableau, ce rendu n’est pas documenté. Dans cet échantillon, Meta a généré le plus de requêtes llms.txt ; cela ne prédit pas son comportement futur.
La fragmentation touche aussi les referrals. En avril 2026, ChatGPT en représentait 76,85 %, devant Gemini à 9 %, Perplexity à 7,73 %, Copilot à 3,76 % et Claude à 2,66 %, selon StatCounter. Une optimisation pensée pour un seul assistant couvre donc un marché de moins en moins homogène.
Les modules GEO valent-ils leur bouton magique ?
Ils automatisent des fichiers et des métadonnées utiles, mais aucun ne crée à lui seul l’autorité, la fraîcheur ou les mentions tierces. Leur valeur dépend surtout du coût de maintenance qu’ils retirent.
Produits documentés au 5 septembre 2026
- Yoast 28.4 génère
llms.txtet expose son graphe d’entités par endpoint REST. - AIOSEO 5.0.0.1 propose un générateur pour
llms.txtetllms-full.txt. - Rank Math 1.0.277.2 combine son module LLMS Txt avec un agent MCP.
- SEOPress 10.1 documente
llms.txt, les en-têtesLink,mcp.jsonetagent-card.json. - Shopify permet de personnaliser
llms.txt,llms-full.txtetagents.mddepuis le 28 mai 2026. - Nuxt propose un module officiel
nuxt-llms, affiché autour de 32 000 téléchargements hebdomadaires lors de la consultation.
Ces versions et fonctions viennent des pages officielles listées dans les sources, consultées le 5 septembre 2026. Elles mesurent la maturité de l’intégration, pas un gain de visibilité démontré. Choisissez l’interface réellement nécessaire, sans classement arbitraire.
Quelle utilité reste-t-il à llms.txt ?
Publiez un fichier propre si sa génération et sa maintenance coûtent presque rien. Il peut fournir un sommaire à un agent qui choisit de le consulter ; aucune hausse de découverte, de citation ou de classement n’est démontrée. Vérifiez les accès dans vos logs plutôt que de déduire son utilité de sa seule présence.
Quels signaux corrèlent vraiment avec les citations IA ?
Les associations qui reviennent dans plusieurs jeux de données observationnels concernent les mentions de marque, la fraîcheur utile, la clarté de l’entité et une structure facile à extraire ; aucun de ces éléments n’est un levier causal isolé. Ces études de fournisseurs utilisent des échantillons et des définitions incompatibles ; leurs amplitudes ne se comparent pas directement.
Mentions et entité avant les backlinks seuls
Sur 75 000 marques, Ahrefs mesure une corrélation de 0,737 entre visibilité IA et mentions de marque sur YouTube. Les mentions de marque sur le Web se situent entre 0,66 et 0,71, contre environ 0,22 pour les backlinks.
Mais corrélation ne signifie pas causalité. Une marque connue produit naturellement plus de mentions, liens, recherches et citations. Ajouter une vidéo ou du balisage ne garantit rien.
Votre micro-checklist d’entité tient en cinq points :
- nom commercial identique sur le site et les profils tiers ;
- pages À propos et contact accessibles ;
- auteurs identifiés avec une biographie ;
- balisage
OrganizationouPersonconforme au contenu visible ; - propriétés
sameAsvers les profils officiels.
Le JSON-LD décrit l’entité ; il ne crée ni autorité ni citation.
La fraîcheur utile, pas la date cosmétique
TheStacc observe un contenu cité 368 jours plus frais que les résultats organiques Google et 76,4 % des principales citations ChatGPT sous 30 jours. Parmi 116 379 citations dont la date était mesurable, soit 1,4 % des 8,2 millions étudiées, Parse.gl mesure un Last-Modified médian de trois jours ; 65,3 % ont moins d’une semaine et 80,6 % moins de 30 jours.
Last-Modified reste un proxy imparfait : un rebuild, un CDN ou un changement de gabarit peut modifier l’en-tête sans amélioration éditoriale. Ne changez donc pas seulement une date. Revalidez chiffres, contenu, captures, compatibilité, liens et recommandations. La fraîcheur utile réduit le risque d’obsolescence ; la fraîcheur cosmétique n’ajoute aucune information.
Structure extractible et preuves propres
Comment mesurer le GEO chaque mois sans se raconter d’histoires ?
Figez les questions et les conditions, séparez les moteurs, conservez les réponses brutes et attendez un signal répété. Sans protocole stable, le suivi mesure vos changements de méthode autant que votre visibilité.
1. Établir trois cycles de référence
Utilisez chaque mois 20 à 30 prompts sur deux ou trois moteurs. Gardez les mêmes langue, région et mode. Ne modifiez pas le panier entre deux cycles ; toute évolution crée une nouvelle version. Établissez trois cycles de référence avant d’interpréter une tendance.
La fenêtre glissante de huit semaines ne convient qu’à un suivi hebdomadaire automatisé. Elle ne doit pas être mélangée au protocole mensuel manuel.
2. Conserver une fiche de collecte complète
Pour chaque réponse, notez :
- le prompt exact ;
- le moteur et son mode ;
- l’activation ou non de la recherche Web ;
- le modèle, s’il est visible ;
- la langue et le pays ;
- une session vierge ou un compte connecté ;
- la personnalisation désactivée, si possible ;
- la date et l’heure ;
- la réponse brute et les URLs citées.
Répétez deux ou trois fois un petit sous-échantillon sentinelle pour estimer la variabilité. Pour Google AI Overviews, consignez « aperçu non déclenché » comme un résultat distinct, pas comme une réponse vide.
3. Mesurer chaque moteur séparément
L’étude CONSENSUS de Lucreya rapporte le même gagnant sur trois moteurs pour seulement 5 de ses 14 requêtes de catégorie et d’intention, soit 36 %. Ne fusionnez donc pas les résultats. Comparez chaque moteur à sa propre référence historique.
Suivez des ratios lisibles :
- Brand Visibility % : nombre de réponses qui mentionnent la marque divisé par le nombre total de réponses ;
- Citation Rate : nombre de réponses qui citent votre domaine divisé par le nombre total de réponses ;
- AI Share of Voice : mentions de votre marque parmi celles de votre marque et de vos concurrents ;
- Average Mention Position : position moyenne de la première mention, facultative pour une PME.
Une réponse compte au plus une mention par marque. Définissez avant la collecte le traitement des ex æquo et des réponses sans liste, puis conservez cette règle. Distinguez aussi les « ghost citations », où le domaine apparaît sans le nom de marque : une part importante des présences de marque peut être invisible en analytics. Les scores composites restent propres à chaque fournisseur.
4. Attendre un signal répété et le confronter aux logs
N’agissez que sur une évolution de même sens pendant deux cycles, confirmée par les logs ou par des citations réelles. Résumez chaque moteur avec les URLs gagnantes ou perdantes, vos hypothèses et une seule action testée.
GA4 ne voit pas les robots qui n’exécutent pas JavaScript. Dans les logs, recherchez les user-agents déclarés, puis vérifiez les plages IP publiées lorsqu’elles existent. Anthropic n’en publie pas : un trafic identifié par le seul user-agent Claude doit rester non vérifiable. Pour les robots qui le permettent, contrôlez le reverse DNS, puis confirmez que le nom obtenu se résout vers l’IP d’origine.
D. Plouffe rapporte, sur cinq mois de logs d’un seul site, que seuls 12 % des « Googlebot » et 41 % des « ChatGPT-User » observés étaient authentiques. Il rapporte aussi un clic identifié pour 280 fetches dans ces logs. Ce cas monossite illustre le spoofing et l’écart entre activité robot et visite ; il ne constitue pas une moyenne du Web.
Conclusion
Le GEO n’est pas un canal autonome. C’est une discipline de lisibilité, de cohérence d’entité et d’observation. Rendre une page accessible, répondre clairement, prouver ses affirmations et maintenir l’information à jour profite aussi au Web classique.
Je publierais un llms.txt propre si l’outil le génère sans maintenance. Je consacrerais l’essentiel du temps aux pages réellement utiles, aux preuves originales, aux mentions tierces et aux logs.
Mon ordre d’investissement serait simple :
- accessibilité technique ;
- contenu citable et à jour ;
- cohérence de l’entité ;
- mesure mensuelle ;
- plateforme payante seulement à l’échelle.
Choisissez votre panier de prompts, capturez trois cycles comparables, puis testez une seule amélioration à la fois.
Sources
Liens consultés le 5 septembre 2026 :
- Optimizing Visibility in Generative Engines: A Critical Survey — arXiv
- Does GEO Actually Work? — Buffy
- AI Traffic Research Study — SE Ranking
- AI chatbot referral market — StatCounter
- AI Overviews: One Year of Presence, Size and Citing — BrightEdge
- AI Brand Visibility Correlations — Ahrefs
- Freshness Signals in AI Search — theStacc
- How Old Are the Pages AI Cites? — Parse.gl
- The CONSENSUS Protocol — Lucreya
- Do AI Bots Read llms.txt? — EZY Research
- Reading AI Traffic in Server Logs — D. Plouffe
- Yoast SEO — WordPress.org
- AIOSEO llms.txt Generator
- Rank Math LLMS.txt
- SEOPress Agent Readiness
- Customize llms.txt, llms-full.txt, and agents.md — Shopify
- Nuxt LLMs module
Questions fréquentes
GEO : que signifie ce sigle ?
GEO signifie Generative Engine Optimization : l'optimisation d'un site pour être cité dans les réponses des assistants IA comme ChatGPT, Perplexity, Gemini ou Claude. Sans rapport avec la géolocalisation.
Le GEO remplace-t-il le SEO traditionnel ?
Non. Le GEO complète le SEO en rendant une source plus compréhensible et citable dans les réponses IA, mais l’indexation, l’autorité, la qualité technique et l’utilité du contenu restent essentielles.
Le fichier llms.txt améliore-t-il le classement dans ChatGPT ou Gemini ?
Aucune preuve ne montre que llms.txt est un signal de classement. Il peut fournir un sommaire à un agent qui choisit de le consulter, sans hausse démontrée de découverte, de citation ou de classement.
Quels signaux sont associés aux citations par les assistants IA ?
Les études observent surtout des associations avec les mentions de marque, la fraîcheur utile, une entité cohérente, une structure answer-first et des données originales. Une corrélation isolée ne prouve pas la causalité.
Comment mesurer sa visibilité dans les réponses IA ?
Conservez un panier versionné de 20 à 30 prompts, testez chaque mois deux ou trois moteurs dans les mêmes conditions, gardez les réponses brutes et comparez chaque moteur à sa propre référence. Complétez avec des citations réelles et des logs serveur vérifiés.
Faut-il autoriser tous les robots IA dans robots.txt ?
Il n’existe pas de règle universelle. Séparez les robots d’entraînement, d’indexation et de récupération à la demande, puis arbitrez selon vos objectifs et vos droits ; bloquer un robot peut réduire certaines citations sans empêcher toute réutilisation indirecte.